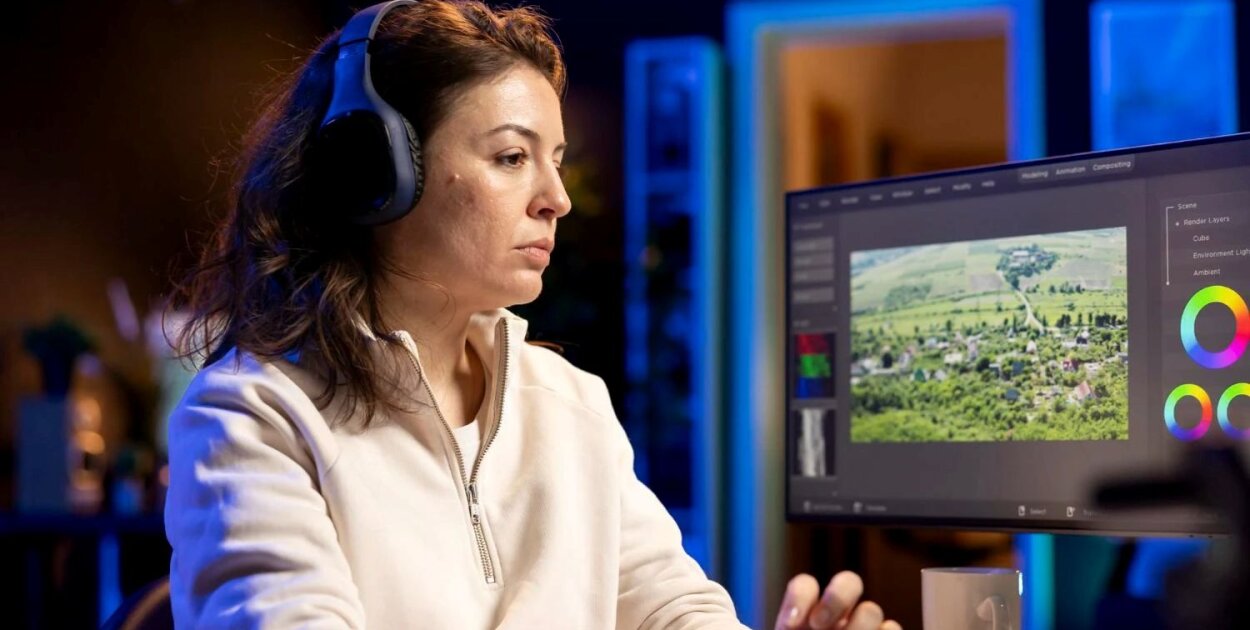
 Obraz autorstwa DC Studio na Magnific
U podstaw nowoczesnych generatorów animacji leżą modele głębokiego uczenia, w szczególności sieci neuronowe wytrenowane na ogromnych zbiorach danych zawierających miliony obrazów, filmów i ich opisów tekstowych. Modele dyfuzji, transformery i architektury oparte na mechanizmie uwagi (ang. attention mechanism) pozwalają systemowi AI rozumieć relacje między słowami opisującymi scenę a jej wizualną reprezentacją.
W praktyce oznacza to, że użytkownik może wpisać opis tekstowy w języku naturalnym, na przykład "spacer człowieka przez jesienny park" i model generatywny AI stworzy sekwencję klatek tworzącą animację odpowiadającą temu opisowi. Proces ten nazywa się syntezą tekst-do-wideo (ang. text-to-video synthesis) i jest jednym z najszybciej rozwijających się obszarów w badaniach nad AI.
Przykładem takiego podejścia jest Adobe Firefly, gdzie interfejs pokazujący, jak zrobić animacje przy użyciu AI, abstrahuje złożoność modeli głębokiego uczenia za intuicyjnym formularzem wprowadzania danych, dając użytkownikom dostęp do zaawansowanych możliwości bez konieczności rozumienia mechanizmów matematycznych stojących za tym procesem.
Nowoczesne modele syntezy wideo działają najczęściej w kilku etapach. Pierwszym jest enkodowanie opisu tekstowego przez sieć neuronową rozumiejącą język naturalny. Modele takie jak CLIP (Contrastive Language-Image Pre-Training) lub architektury transformerowe przekształcają opis słowny w wektorową reprezentację numeryczną, zwaną osadzeniem (ang. embedding).
Drugim etapem jest generowanie sekwencji klatek wideo, które są spójne zarówno wizualnie, jak i czasowo. Tu kluczowym wyzwaniem jest zachowanie ciągłości ruchu między kolejnymi klatkami, tak by animacja wyglądała płynnie, a nie jak seria niepowiązanych obrazów.
Trzecim etapem jest renderowanie i postprocessing, czyli wygładzenie wygenerowanych klatek, poprawa jakości i ewentualne dostosowanie stylistyczne do oczekiwań użytkownika.
Pomimo imponujących postępów, generatywna synteza wideo nadal napotyka na szereg trudności technicznych. Zachowanie spójności fizycznej, czyli realistycznego ruchu obiektów zgodnego z prawami fizyki, pozostaje jednym z najtrudniejszych wyzwań. Systemy AI nauczone na danych statystycznych nie zawsze rozumieją, że rzucona piłka musi poruszać się po określonej trajektorii lub że woda w naczyniu zachowuje się zgodnie z zasadami dynamiki cieczy.
Problematyczne jest też generowanie twarzy i ciał ludzkich w ruchu, które muszą spełniać bardzo wysokie standardy percepcyjne. Ludzki mózg jest wyjątkowo wyczulony na nieprawidłowości w ruchach ludzkiego ciała, co sprawia, że błędy AI w tej dziedzinie są szczególnie zauważalne.
Postęp w dziedzinie generatywnej syntezy wideo jest dokumentowany przez wiodące konferencje naukowe, takie jak NeurIPS, CVPR czy ICCV. Każdego roku prezentowane są setki artykułów opisujących nowe metody poprawy jakości, prędkości i kontrolowalności modeli text-to-video. Prace takie jak VideoPoet od Google czy Sora od OpenAI pokazują, że granica między wygenerowanym a nagranym materiałem wideo jest coraz trudniejsza do precyzyjnego wskazania.
Według Nature Machine Intelligence, jednego z wiodących czasopism naukowych w dziedzinie AI, synteza wideo to jeden z obszarów, gdzie przełomowe osiągnięcia następują szybciej niż w jakiejkolwiek innej gałęzi uczenia maszynowego, co odzwierciedla zarówno intensywność badań, jak i ogromne zainteresowanie komercyjne tą technologią.
Technologia generowania animacji i wideo przez AI rodzi istotne pytania społeczne i etyczne. Możliwość tworzenia realistycznie wyglądających wideo z udziałem prawdziwych ludzi bez ich wiedzy i zgody, znana jako deepfake, jest jednym z poważniejszych zagrożeń związanych z tą technologią.
Środowisko naukowe i organizacje normalizacyjne pracują nad standardami i narzędziami umożliwiającymi wykrywanie treści syntetycznych. Znaczniki cyfrowe i metadane potwierdzające autentyczność materiałów wizualnych stają się coraz ważniejszym elementem ekosystemu treści cyfrowych.
Pojawienie się generatywnych narzędzi AI zmienia, ale nie eliminuje roli ludzkich twórców w procesie animacji. Narzędzia AI działają najlepiej jako wsparcie pracy kreatywnej: skracają czas produkcji, eliminują żmudne zadania techniczne i pozwalają skupić się na koncepcji i narracji. Artyści i animatorzy, którzy nauczą się efektywnie współpracować z narzędziami AI, zyskają możliwość realizowania projektów, które wcześniej przekraczały ich możliwości czasowe lub budżetowe.
Przyszłość animacji będzie prawdopodobnie hybrydowa: AI jako warstwa techniczna, człowiek jako kierownik artystyczny i opowiadacz historii.
Naukowcy pracujący nad syntezą wideo AI eksplorują kilka obiecujących kierunków, które w ciągu najbliższych lat mogą zasadniczo zmienić możliwości generatywnych modeli. Kontrola fizyki jest jednym z kluczowych celów: modele uczące się zasad dynamiki, grawitacji i interakcji materiałowych będą generować wideo wyglądające bardziej realistycznie, ponieważ obiekty będą poruszać się zgodnie z prawami fizyki. Długookresowa spójność to kolejne wyzwanie: obecne modele tracą spójność wizualną przy dłuższych sekwencjach, a badania skupiają się na mechanizmach pamięci długoterminowej pozwalających utrzymać tę spójność przez minuty, a nie sekundy. Interaktywna synteza wideo, gdzie użytkownik może w czasie rzeczywistym zmieniać elementy generowanej sceny, to obszar, który połączy generatywne AI z technikami renderowania w czasie rzeczywistym, otwierając nowe możliwości w grach i interaktywnych instalacjach artystycznych.